甄宝园
手里的 PDF 大多不能复制。扫描的合同、论文、财报,框选一片文字,出来的是图。想改一个字,只能重打一遍。
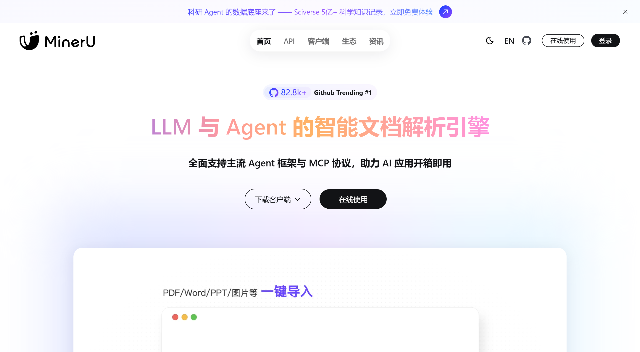
MinerU 做的就是这件事:把 PDF、Word、PPT、图片丢进去,出来一份干净的 Markdown。标题是标题,表格是表格,公式还是公式。
它跟一般的转换工具差在排版理解上。双栏论文能按阅读顺序输出,不会左边一行右边一行地串;表格不会塌成一长串逗号;公式转成 LaTeX,复制到别处还能接着编辑。这一层做不好,转出来的文字看着齐,其实没法用。
扫描件也能认。手机拍的纸质文件,歪了、有阴影,它先做纠偏再识别。我拿一份倾斜三十度的收据试过,数字基本没错。
真正让我留下它的是另一件事。手上有一份几十页的行业报告,转成 Markdown 之后直接丢给大模型做摘要,省掉了手动摘段落那一大段活。做知识库的人都懂,文档解析不干净,后面检索全是噪音。
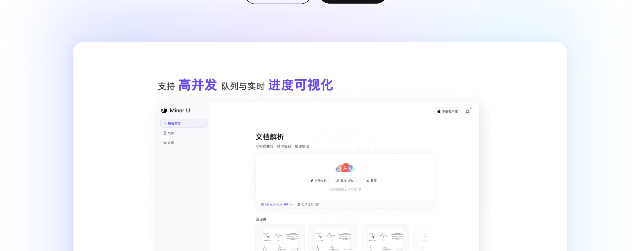
用法有三种:官网在线版,登录就能传,适合偶尔用;桌面客户端,批量拖进去;还有 API 和命令行,写脚本跑。开源版本可以自己部署,模型在本地转,文件不出机器——处理合同这类东西,这一点很要紧。
输出也不止 Markdown。要接进自己系统的话,可以选 JSON,页、块、类型都带着坐标,二次开发省事。
还有个用处是检索。扫描件里的字本来搜不到,转成文本之后全文检索才成立——老档案、旧合同、纸质台账,这类东西一下就有救了。
该说的缺点也说:第一次跑要下模型,几个 G,机器差一点会等很久;页数多的文件要排队;竖排古籍、手写体这些,识别率还是会掉。它不是万能的。
但对大多数「我要把这份 PDF 变成能编辑的文字」的场景,它够用了,而且不要钱。